Задачи и ответственные из расшифровки встречи
Встроенный промпт Autorec уже выделяет решения и задачи. Показываем, что именно он просит, даём два готовых промпта для ответственных, сроков или письма по итогам встречи и объясняем, почему ответственный появляется, только когда кто-то произносит имя.

Один клиент задал нам простой вопрос: как получить короткую сводку с задачами и с тем, кто за что отвечает?
Большая часть этого работает уже с настройками по умолчанию, а остальное — несколько строк в текстовом поле.
Что уже делает встроенный промпт
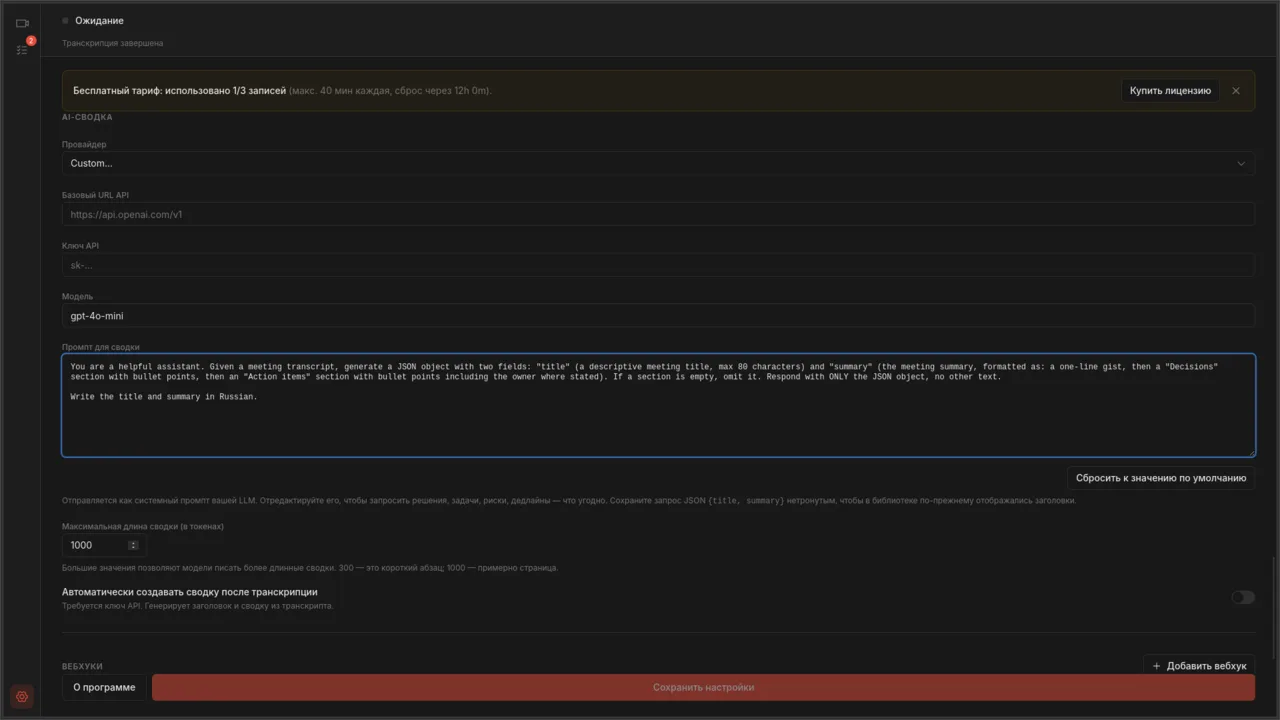
Откройте настройки и найдите раздел AI-сводка. В поле Промпт для сводки показан тот самый текст, который Autorec отправляет вашей модели как системный промпт:
You are a helpful assistant. Given a meeting transcript, generate a JSON object with two fields: "title" (a descriptive meeting title, max 80 characters) and "summary" (the meeting summary, formatted as: a one-line gist, then a "Decisions" section with bullet points, then an "Action items" section with bullet points including the owner where stated). If a section is empty, omit it. Respond with ONLY the JSON object, no other text.То есть вы получаете суть в одну строку, список решений и список задач с ответственным — «where stated», если его назвали. Заголовок становится названием записи в библиотеке. Если на встрече не приняли ни одного решения, раздел просто пропускается, а не заполняется водой.
Сводки работают с любым OpenAI-совместимым эндпоинтом — облачным или на вашем компьютере. Если вы его ещё не настроили, два самых частых варианта описаны в посте о локальных LLM и посте о настройке OpenRouter.
Почему иногда нет ответственного
Autorec расшифровывает с помощью whisper.cpp. Whisper превращает речь в текст с таймкодами, но не определяет, кто говорит, и Autorec не добавляет метки спикеров сверху. В начале строк расшифровки нет ни «Света:», ни «Спикер 2:».
Модель видит только этот текст. Назвать ответственного она может, когда он есть в словах:
- «Света, пришлёшь исправленное предложение до пятницы?» — есть ответственный (Света) и срок (пятница).
- «Кто-нибудь должен обновить документацию» — задача без ответственного, потому что в тексте его нет.
- «Я возьму» — ничего полезного, потому что из расшифровки не понять, кто этот «я».
Поэтому стандартный промпт и говорит «where stated». Промпт, который требует ответственного для каждой задачи, подталкивает модель угадывать, а угаданный ответственный хуже пустого поля.
Исправить это ничего не стоит, и делается это на самой встрече. Когда раздаёте задачи, произносите имя и срок вслух:
«Итак: план миграции готовит Андрей, срок — следующая среда».
Первые пару раз это звучит натянуто. Потом становится обычным завершением встречи, а участники заодно лучше понимают, кому что досталось.
Промпт первый: сначала задачи, в виде таблицы
В этой версии задачи идут в самом начале, а модель просят свести их в таблицу со столбцами ответственного и срока. Где никого не назвали, она пишет «не назначено», чтобы пробелы сразу бросались в глаза.
Ты — полезный ассистент. По расшифровке встречи сформируй JSON-объект с двумя полями: "title" (понятное название встречи, не длиннее 80 символов) и "summary". Сводку напиши на русском в Markdown в таком порядке: сначала раздел «Задачи» в виде таблицы со столбцами «Задача», «Ответственный», «Срок». Указывай ответственного или срок, только если они прямо названы в расшифровке. Если не названы, пиши «не назначено» или «без срока». Затем раздел «Решения» маркированным списком. Затем раздел «Открытые вопросы» маркированным списком. В конце — суть встречи одной строкой. Если раздел пустой, пропусти его. Не придумывай имена, даты и задачи. Ответь ТОЛЬКО JSON-объектом, без какого-либо другого текста.Ключевая фраза — «Указывай ответственного или срок, только если они прямо названы». Без неё многие модели заполняют таблицу правдоподобными догадками.
Промпт второй: письмо по итогам встречи
Если на самом деле вам нужно сообщение, которое вы потом разошлёте, попросите прямо его.
Ты — полезный ассистент. По расшифровке встречи сформируй JSON-объект с двумя полями: "title" (понятное название встречи, не длиннее 80 символов) и "summary". Поле summary — короткое письмо на русском, которое я разошлю участникам по итогам встречи. Начни с краткого итога в два предложения, затем перечисли решения, затем задачи в формате «Имя: задача (срок)», используя только имена и даты, которые прозвучали в расшифровке. Закончи одной строкой с просьбой ответить, если что-то указано неверно. Обычный текст, без заголовков Markdown. Ответь ТОЛЬКО JSON-объектом, без какого-либо другого текста.Прочитайте письмо, прежде чем отправлять. Модель работает с машинной расшифровкой, а whisper иногда ослышится в имени.
Сохраните JSON-обёртку
Оба промпта сохраняют первую половину стандартного: просьбу сформировать JSON-объект с двумя полями, title и summary, и требование ответить ТОЛЬКО JSON-объектом. Autorec ждёт ответ именно такой формы, а заголовок — это то, что показывает библиотека. Под полем промпта Autorec даже напоминает: сохраните запрос JSON-объекта {title, summary} нетронутым. Меняйте то, что внутри summary, а обёртку не трогайте.
Ещё две детали о том, как это работает:
- Отредактированный промпт отправляется как есть. Autorec ничего к нему не добавляет. К стандартному промпту Autorec дописывает строку «пиши на таком-то языке», если интерфейс приложения не на английском: с русским интерфейсом сводка по умолчанию и так придёт на русском, а Whisper распознаёт русскую речь. Если же вы правите промпт, укажите язык сами — например, «Напиши заголовок и сводку на русском». Оба промпта выше это уже делают.
- Сбросить к значению по умолчанию — кнопка в самом редакторе. Она возвращает в поле встроенный текст, так что экспериментами оригинал не потерять.
Чтобы изменения вступили в силу, нажмите Сохранить настройки внизу.
Лимит токенов
Под промптом есть поле Максимальная длина сводки (в токенах). По умолчанию — 1000. Подсказка рядом гласит: 300 — это короткий абзац, 1000 — примерно страница. Autorec принимает значения от 100 до 2000, а всё, что выходит за эти пределы, приводит к ближайшей границе.
Это ограничение длины ответа модели. Если сводка обрывается на полуслове или JSON так и не закрывается и сводка не создаётся, причина обычно в этом лимите. Увеличьте его, когда:
- вы используете табличный промпт на встрече с множеством задач;
- просите письмо по итогам плюс решения;
- звонок был длинным: модель получает расшифровку целиком, поэтому двухчасовая встреча может дать больше задач, чем вмещают 1000 токенов (максимум — 2000);
- модель склонна к длинным многословным ответам.
Уменьшите его, если вам нужна короткая суть и вы платите за токены. Увеличение лимита не делает сводки длиннее — это решает промпт. Более высокий лимит лишь не даёт модели оборваться.
Старые записи
Отредактированный промпт работает и для прошлых звонков. Откройте запись в библиотеке и нажмите Создать резюме в окне видео. Кнопка прогонит промпт в его нынешнем сохранённом виде по расшифровке этой записи. Она неактивна, если расшифровки ещё нет или если эндпоинту нужен API-ключ, а он не задан. Локальным серверам ключ не нужен. Если включено Автоматически создавать сводку после расшифровки, новые записи получают сводку сразу, как только готова расшифровка.
Так что промпт удобно настраивать по кругу: выбрать одну настоящую встречу, отредактировать, сохранить, нажать Создать резюме, прочитать результат и повторить. Обычно хватает трёх-четырёх итераций.

На скриншоте демонстрационная запись, поэтому в строках её расшифровки есть имена. В ваших будут таймкоды и слова в том виде, в каком их произнесли, а имена — только там, где их кто-то назвал.
Куда уходит расшифровка
С локальной моделью через Ollama или LM Studio расшифровка остаётся на вашем компьютере. С облачным эндпоинтом текст расшифровки при создании сводки отправляется этому провайдеру. Вы выбираете провайдера сами, и для звонков с клиентами это важно. Варианты разбирают пост о GDPR и пост о конфиденциальности в OpenRouter.
Если коротко
- «Настройки → AI-сводка»: вставьте один из промптов выше и нажмите «Сохранить настройки».
- Увеличьте Максимальная длина сводки (в токенах), если ответ обрывается.
- Раздавая задачи, называйте вслух имена и сроки.
- Нажмите Создать резюме на свежей записи и сравните.
- Пробегите результат глазами, прежде чем он уйдёт кому-то ещё.
Если вы отправляете сводки в заметки, пост о Notion и Obsidian показывает шаблон, в который хорошо ложится таблица в Markdown.
Own your meeting recorder once
Local, private meeting recording for a one-time fee. No monthly bill, no assistant joining your calls.
See pricingСвязанные статьи
Больше о локальной записи, транскрипции и автоматизации вокруг них.
Как добавлять заметки с встреч в Notion или Obsidian без копирования
Заметки с встреч должны сохраняться там, где их можно легко найти позже, а не разбрасываться по трём разным приложениям. Вот как организовать локальный процесс сохранения для Notion, Obsidian и похожих инструментов.

Расшифровка встреч локально с помощью Whisper
Тихий и надёжный способ получать расшифровки ваших встреч, не загружая их никуда. Локальная запись, локальная Whisper, при желании — дополнительный ИИ.
Автоматизированная система расшифровки встреч, которая не подведёт
Когда вы обрабатываете десятки записей в неделю, узким местом становится работа с файлами, а не ИИ. Вот рабочий процесс пакетной расшифровки, построенный вокруг этого.