RODO a podsumowania spotkań przez AI: jaki endpoint wybrać
Autorec wysyła transkrypcję do wybranego przez ciebie dostawcy AI i nic poza nią. Co to oznacza w świetle RODO, jak wypadają Mistral, Scaleway, IONOS, OpenAI i Anthropic, i kiedy lepszym wyjściem jest model lokalny.
Transkrypcja w Autorec działa na twoim komputerze. Podsumowanie AI to jedyny krok, który może z niego wyjść. Jeśli je włączysz, transkrypcja trafia do wybranego przez ciebie dostawcy LLM, a od tej chwili ten dostawca jest podmiotem przetwarzającym wszystkie dane osobowe, które padły na spotkaniu.
Ten wpis dotyczy wyboru tego dostawcy. To nie jest porada prawna. O tym, na co pozwala twoja podstawa prawna i apetyt na ryzyko, decyduje inspektor ochrony danych albo prawnik. Informacje o dostawcach pochodzą z ich własnej dokumentacji i zostały sprawdzone w październiku 2026. Zasady się zmieniają, więc zanim oprzesz się na którymś wierszu, zajrzyj na podlinkowane strony.
Co Autorec faktycznie wysyła
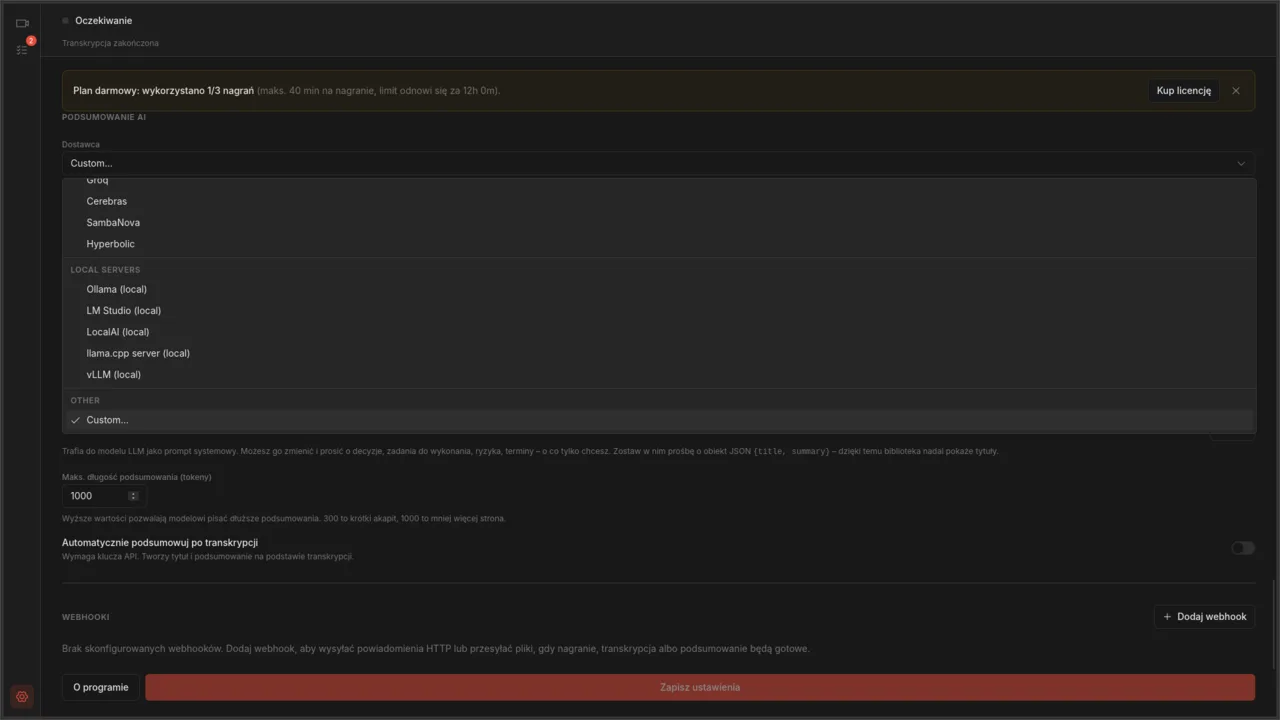
Podsumowanie AI w Autorec jest wyłączone, dopóki nie dodasz dostawcy w Ustawienia → Podsumowanie AI. Kiedy działa, z twojego komputera wychodzi jedno żądanie HTTPS, prosto pod Bazowy URL API, który ustawiłeś. Po drodze nie ma żadnego serwera Autorec.
Treść żądania zawiera:
- twój prompt podsumowania jako wiadomość systemową
- tekst transkrypcji jako wiadomość użytkownika
- nazwę modelu i maksymalną długość podsumowania
Do tego dochodzą dodatkowe pola, które sam dopiszesz w Extra request fields (JSON), na przykład opcje routingu u dostawcy. To ustawienia, a nie dane o spotkaniu. Nic więcej nie wychodzi. Czyli żadnego dźwięku, wideo, zrzutów ekranu, nazw plików ani listy uczestników. Wysyłana jest cała transkrypcja, więc długie spotkanie oznacza dużo tekstu.
Tytuł i podsumowanie, które wracają, zapisują się obok nagrania na twoim dysku. Klucz API leży w lokalnej konfiguracji Autorec, a przy serwerach lokalnych w ogóle nie jest potrzebny.
Dźwięk i obraz, czyli głosy i twarze, nigdy nie opuszczają komputera. Tekst tak, a tekst nadal jest daną osobową, kiedy ktoś na głos wymienia nazwiska, dane o zdrowiu albo wynagrodzenia. Transkrypcja nie staje się anonimowa tylko dlatego, że to sam tekst.
Nasz wpis o RODO i HIPAA omawia stronę nagrywania: podstawę prawną, zgodę i retencję. Wszystko, co tam piszemy, nadal obowiązuje. Ten wpis dokłada krok z dostawcą.
Co sprawdzić przed wyborem dostawcy
Większość sprawy rozstrzygają cztery pytania.
Gdzie dane są przetwarzane? UE to nie zaklęcie, ale zdejmuje ze stołu większość kwestii związanych z przekazywaniem danych. Przetwarzanie w USA wymaga podstawy do przekazania danych i oceny skutków przekazania.
Czy jest umowa powierzenia przetwarzania danych (DPA)? Jeśli dostawca przetwarza dane osobowe w twoim imieniu, art. 28 wymaga umowy. Sprawdź, czy możesz ją zaakceptować bez rozmowy z działem sprzedaży.
Jak długo treść jest przechowywana? Wielu dostawców API trzyma prompty przez krótki czas na potrzeby monitorowania nadużyć, nawet jeśli nie trenuje na nich modeli. „Zero retention” to zwykle coś, o co trzeba poprosić, a nie ustawienie domyślne.
Czy treść służy do trenowania? Przy ruchu przez API u dużych graczy rzadko jest to już ustawienie domyślne, ale nie wszędzie tak samo. Bywa też, że darmowy i płatny plan różnią się pod tym względem.
Dostawcy z hostingiem w UE
Mistral
Mistral to pierwsza opcja z UE na liście dostawców w Autorec (Dostawca → Mistral, bazowy URL https://api.mistral.ai/v1, domyślny model mistral-small-latest).
- Region: centrum pomocy Mistrala podaje, że dane są domyślnie hostowane w Unii Europejskiej, a w Stanach Zjednoczonych tylko wtedy, gdy świadomie korzystasz z amerykańskiego endpointu API. W swoim Trust Center Mistral wymienia też podwykonawców przetwarzania, w tym niektórych spoza UE.
- DPA: Mistral publikuje Data Processing Addendum w ramach warunków komercyjnych.
- Trenowanie: ten wiersz trzeba przeczytać uważnie. Według centrum pomocy przy rozliczeniu pay-as-you-go możesz w każdej chwili zrezygnować z wykorzystania danych do trenowania, a przełącznik jest w Mistral Studio, w Privacy → Anonymous improvement data. Darmowy tryb Studio wprost mówi, że Mistral może trenować swoje modele na twoich danych. Czat dla konsumentów i API mają osobne przełączniki. Niczego więc nie zakładaj: otwórz stronę Privacy na koncie, którego klucz wpisujesz do Autorec, i sprawdź.
- Retencja: w płatnych planach Mistral oferuje Zero Data Retention dla obsługiwanych wywołań API, w tym chat completions. Prosi się o nie przez support, a Mistral może się zgodzić albo odmówić. Na stronach pomocy Mistrala, do których dotarłem, nie ma domyślnego okresu przechowywania treści z API, więc nie podam żadnej liczby. Zapytaj albo przeczytaj DPA.
Scaleway
Generative APIs od Scaleway są hostowane w Paryżu i reklamowane jako zgodne z OpenAI, łącznie z endpointem chat completions. W Autorec nie ma dla nich presetu, więc wybierz Custom… i wpisz bazowy URL z konsoli Scaleway.
Według strony Scaleway o prywatności danych firma nie zbiera, nie czyta, nie wykorzystuje ponownie ani nie analizuje promptów ani odpowiedzi i nie trenuje na nich modeli. Wyjątkiem jest dochodzenie w sprawie nadużycia lub awarii: wtedy dane mogą być przechowywane do dwóch tygodni. Strona wskazuje Scaleway jako podmiot przetwarzający i w kwestii umownej odsyła do polityki prywatności i warunków usług AI.
IONOS
IONOS AI Model Hub opisuje endpointy zgodne z OpenAI i podaje, że całe przetwarzanie odbywa się w niemieckich centrach danych (Berlin), a dane klientów nigdy nie służą do trenowania modeli. Nie znalazłem podanego okresu przechowywania, więc zapytaj o to, zanim przepuścisz przez tę usługę treść spotkań. Tu również wybierz Custom….
Inni
OVHcloud AI Endpoints i Aleph Alpha też są europejskie. W trakcie pisania nie udało mi się potwierdzić ich aktualnych warunków ani zgodności API na stronach źródłowych, więc nie ma ich w tabeli.
Dostawcy z USA
OpenAI i Anthropic mają w Autorec gotowe presety. Ich domyślne ustawienia API są lepsze, niż się powszechnie sądzi. Otwartą kwestią jest przekazywanie danych do USA, a nie trenowanie.
- OpenAI: według dokumentacji dane z API nie służą do trenowania modeli, chyba że sam to włączysz, a logi monitorowania nadużyć są domyślnie przechowywane do 30 dni. Zero Data Retention wymaga wcześniejszej zgody. Rezydencja danych w UE (prefiks
eu.api.openai.com) to ustawienie projektu, które ma warunki, na przykład Zero Data Retention albo zmodyfikowane monitorowanie nadużyć, i nie obejmuje każdego modelu. - Anthropic: według centrum prywatności dane wejściowe i wyjściowe użytkowników API są usuwane z backendu w ciągu 30 dni, a dane z produktów komercyjnych domyślnie nie służą do trenowania. DPA ze standardowymi klauzulami umownymi jest automatycznie włączona do Commercial Terms. Nie udało mi się potwierdzić opcji przetwarzania wyłącznie w UE, więc jej nie obiecuję.
W skrócie
| Dostawca | Region przetwarzania | Retencja | Trenowanie | DPA |
|---|---|---|---|---|
| Mistral | Domyślnie UE; endpoint w USA na żądanie | ZDR na prośbę w płatnych planach; domyślny okres niepodany na sprawdzonych stronach | Przełącznik rezygnacji w Studio; dane z darmowego planu mogą być używane | Opublikowany aneks |
| Scaleway | Paryż, Francja | Bez przechowywania promptów; do dwóch tygodni przy dochodzeniu w sprawie awarii | Nie | Warunki dla podmiotu przetwarzającego w polityce prywatności i warunkach AI |
| IONOS | Niemcy (Berlin) | Niepodana | Nigdy, według IONOS | Niesprawdzone |
| OpenAI | USA; rezydencja w UE opcjonalnie, z warunkami | Do 30 dni (logi nadużyć); ZDR po akceptacji | Nie, chyba że to włączysz | Niesprawdzone |
| Anthropic | Brak deklaracji przetwarzania wyłącznie w UE | Usuwane w ciągu 30 dni | Domyślnie nie | Włączona do Commercial Terms |
„Niesprawdzone” oznacza, że tego nie czytałem, a nie że to nie istnieje.
Bramka to kolejny podmiot
Agregator taki jak OpenRouter przed modelem sprawia, że podmiotem przetwarzającym staje się także agregator, a do tego firma, która uruchamia model. Można to ograniczyć, także opcjami na poziomie żądania, takimi jak flaga zero data retention w OpenRouter, którą ustawisz w Extra request fields (JSON). Nasz wpis o prywatności w OpenRouter omawia te ustawienia. Jeśli zależy ci na czystej dokumentacji, jedną bezpośrednią umowę z jednym dostawcą z UE łatwiej opisać niż dodatkową warstwę routingu.
Kiedy lokalnie znaczy lepiej
Endpoint w UE zmniejsza ryzyko. Model na twoim własnym komputerze całkowicie usuwa podmiot przetwarzający: nie ma dostawcy, DPA, przekazywania danych ani pytania o retencję. Przy spotkaniach z danymi o zdrowiu, objętych tajemnicą zawodową, dotyczących spraw kadrowych albo czegokolwiek pod ścisłym NDA z klientem łatwiej zwykle obronić właśnie tę decyzję.
Kosztem jest sprzęt i jakość. Mały model na laptopie pisze mniej dopracowane podsumowania niż duży model hostowany, a długie transkrypcje przetwarza powoli. Nasz poradnik o lokalnych LLM pokazuje, jak skierować Autorec na Ollamę albo LM Studio.
Rozsądny podział:
- rutynowe spotkania wewnętrzne: endpoint hostowany w UE z wyłączonym trenowaniem i podpisaną DPA
- spotkania wrażliwe: model lokalny albo zero podsumowania i sama transkrypcja
Dostawcę możesz w każdej chwili zmienić w Ustawieniach, a podsumowania powstają dla każdego nagrania osobno, więc ten podział nie musi być zero-jedynkowy.
Krótka lista kontrolna
- Wybierz dostawcę i zaakceptuj jego DPA na koncie, którego klucza użyjesz.
- Sprawdź ustawienie trenowania na tym konkretnym koncie, a nie ogólnie.
- Poproś o Zero Data Retention, jeśli dostawca je oferuje, a twoja ocena ryzyka tego wymaga.
- Poinformuj uczestników, że transkrypcję przetwarza dostawca AI. Informacja o nagrywaniu powinna wymieniać kategorię podmiotu przetwarzającego.
- Wpisz dostawcę do rejestru czynności przetwarzania.
- Zostaw Automatycznie podsumowuj po transkrypcji wyłączone dla spotkań, które chcesz najpierw przejrzeć.
Autorec trzyma dźwięk na twoim komputerze i pokazuje dokładnie, jaki tekst z niego wychodzi. Umowy i zasady to już twoja działka. Stronę nagrywania omawia poradnik o RODO i HIPAA, a to, dlaczego rezygnujemy z botów na spotkaniach, wpis o rejestratorze bez bota.
Źródła
Sprawdzone w październiku 2026:
- Mistral: gdzie przechowywane są dane, rezygnacja z trenowania, Zero Data Retention, centrum prawne
- Scaleway: prywatność danych w Generative APIs
- IONOS: przegląd AI Model Hub
- OpenAI: Data controls
- Anthropic: retencja danych, trenowanie, DPA
Own your meeting recorder once
Local, private meeting recording for a one-time fee. No monthly bill, no assistant joining your calls.
See pricingPowiązane artykuły
Więcej o lokalnym nagrywaniu, transkrypcji i automatyzacji wokół nich.
Nagrywanie spotkań a RODO i HIPAA: jak to ogarnąć bez nerwów
Zgodności z przepisami nie kupisz jako funkcji. To sposób pracy. Tak wygląda nagrywanie spotkań zgodne z duchem RODO (GDPR) i tu HIPAA wymaga czegoś więcej niż zmiany narzędzia.
Podsumowania spotkań z lokalnym LLM: Ollama i LM Studio
Model do podsumowań też może działać na twoim komputerze. Skonfiguruj Ollamę albo LM Studio, wskaż je w Autorec, a nagranie, transkrypcja i podsumowanie nigdy nie opuszczą twojego sprzętu.
Jak zachować prywatność transkrypcji spotkań w OpenRouter
OpenRouter może skierować twoją transkrypcję do dziesiątek dostawców, a część z nich przechowuje prompty. Trzy ustawienia konta i opcjonalny bazowy URL w UE decydują o tym, którzy ją zobaczą.