Yerel LLM ile toplantı özetleri: Ollama ve LM Studio
Özeti üreten modeli de kendi bilgisayarınızda çalıştırın. Ollama'yı ya da LM Studio'yu kurun, Autorec'i ona yönlendirin; kayıt, transkript ve özet bilgisayarınızdan hiç çıkmasın.
Autorec zaten kaydı da transkripsiyonu da sizin bilgisayarınızda yapıyor. Dışarı çıkabilecek tek adım özet, çünkü özet için bir dil modeli gerekiyor ve çoğu kişi barındırılan bir model kullanıyor.
Böyle olmak zorunda değil. Autorec OpenAI uyumlu her uç noktayla konuşabiliyor; Ollama da LM Studio da localhost üzerinde böyle bir uç nokta sunuyor. Autorec’i oraya yönlendirdiğinizde hiçbir aşamada hiçbir şey bilgisayardan çıkmaz. Bu yazıda ikisinin de kurulumunu adım adım anlatıyor, ardından 8, 16 ya da 32 GB RAM için hangi modeli seçeceğinizi ve uzun toplantıların neden varsayılandan daha büyük bir bağlam penceresine ihtiyaç duyduğunu ele alıyoruz.
Gerçekte ne gönderiliyor
Autorec uç noktaya iki şey gönderir: sistem mesajı olarak özet isteminizi, kullanıcı mesajı olarak da transkriptin tamamını. Ses ya da video göndermez. (Yaklaşık 400.000 karakteri, yani kabaca sekiz saatlik konuşmayı aşan transkriptleri Autorec ”[Transcript truncated]” işaretiyle keser.) Yerel bir sunucuyla bu istek http://localhost:11434/v1 (Ollama) ya da http://localhost:1234/v1 (LM Studio) adresine gider ve orada kalır.
1. seçenek: Ollama
- Ollama’yı ollama.com/download adresinden kurun. Linux’ta kurulum betiği
curl -fsSL https://ollama.com/install.sh | sh. macOS ve Windows’ta normal bir yükleyici var. - Terminalde bir model indirin, örneğin
ollama pull qwen3.5:9b. Model önerileri aşağıda. - Çalıştığını kontrol edin: Ollama varsayılan olarak
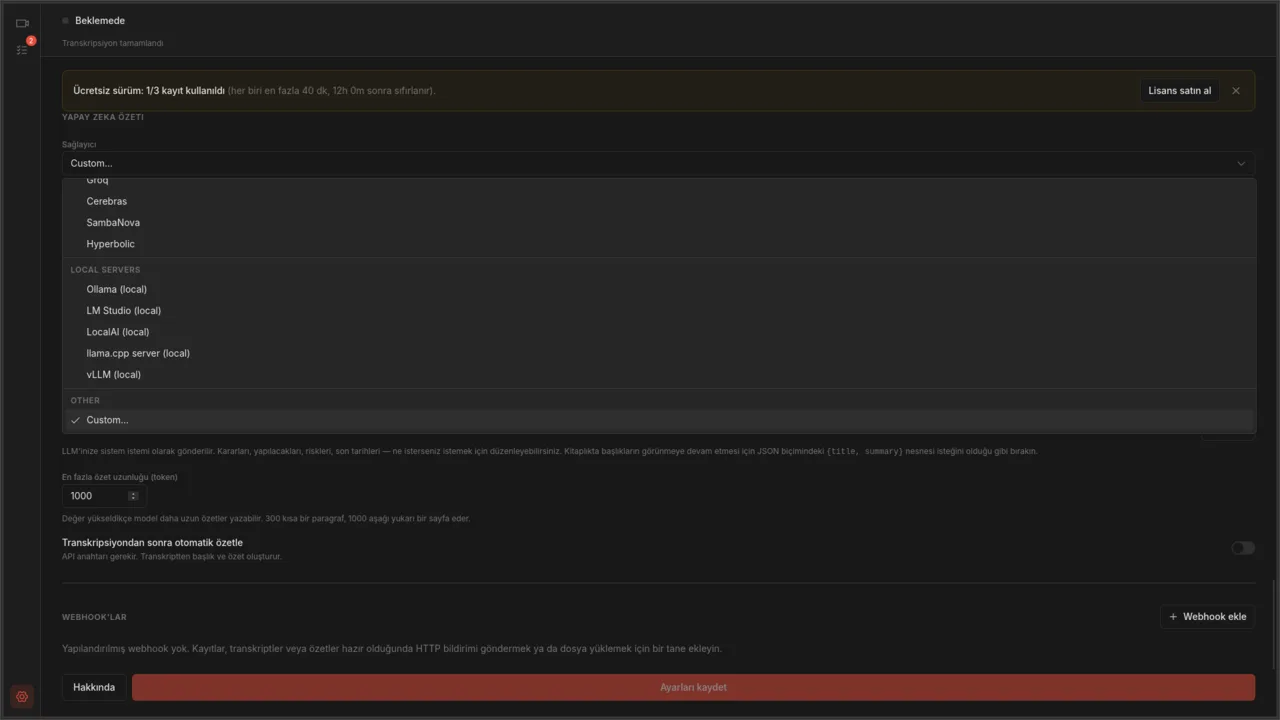
127.0.0.1:11434adresini dinler,ollama psde yüklü modelleri gösterir. - Autorec’te Ayarlar‘ı açın ve Yapay zeka özeti bölümüne inin. Sağlayıcı altında Local servers grubundan Ollama (local) seçeneğini seçin. API temel URL’si
http://localhost:11434/v1olarak dolar. - API anahtarı alanını boş bırakın. Alanda “Not needed for local servers” yazar.
- Model alanına indirdiğiniz etiketi birebir yazın, örneğin
qwen3.5:9b. Hazır ayarllama3.1önerir; bu yalnızca o modeli indirdiyseniz çalışır. - Ayarları kaydet‘e tıklayın.
2. seçenek: LM Studio
- LM Studio’yu lmstudio.ai adresinden kurun ve yerleşik aramasından bir model indirin.
- Sunucuyu başlatın. LM Studio’nun Developer sekmesinde Start server anahtarını açın ya da terminalde
lms server startçalıştırın. Sunucu 1234 numaralı portta çalışır. - Autorec’te Ayarlar → Yapay zeka özeti altında Sağlayıcı olarak LM Studio (local) seçin. Temel URL
http://localhost:1234/v1olur. - API anahtarı alanını boş bırakın.
- LM Studio hazır ayarında varsayılan model yok; model kimliğini LM Studio’da nasıl görünüyorsa aynen yazın.
- Ayarları kaydet‘e tıklayın.
Komut yazmak yerine tıklamayı tercih ediyorsanız LM Studio daha kolay seçenek. Ollama ise daha hafif ve penceresiz biçimde arka planda çalışır.
Tek bir kayıtla deneyin
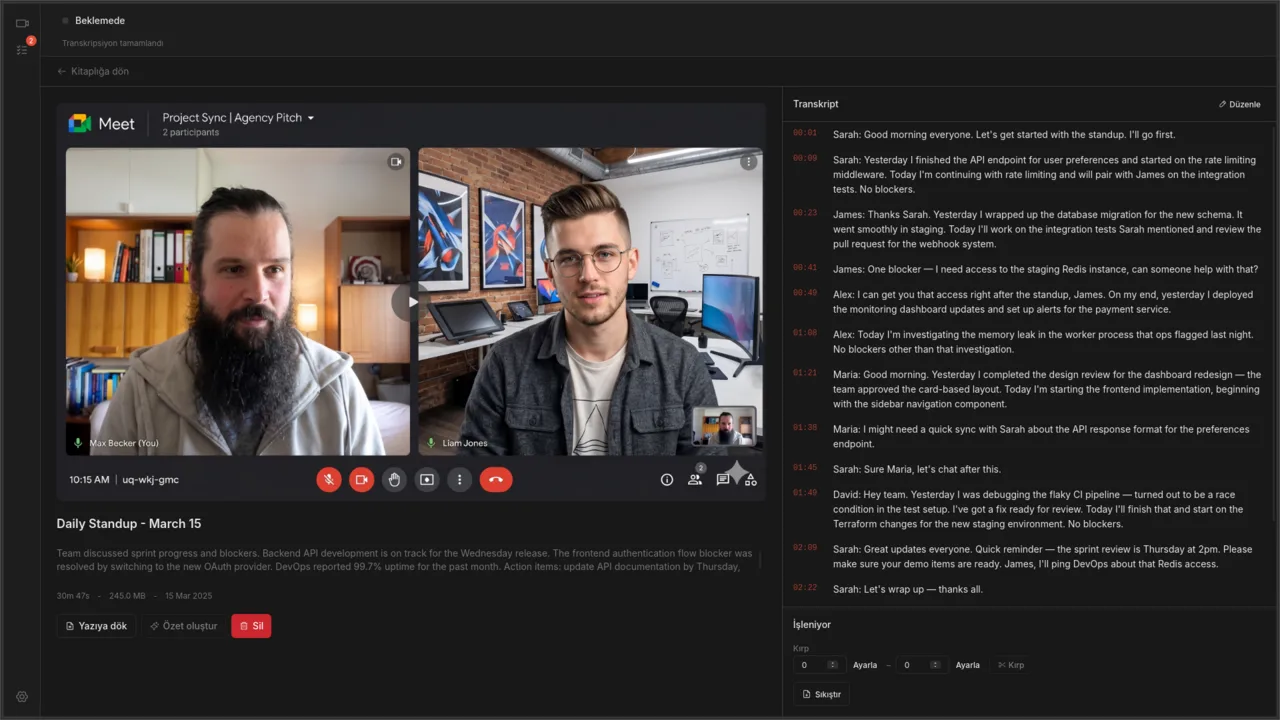
Kitaplığınızda transkripti olan bir kaydı açın ve Özet oluştur‘a tıklayın. Her şey yolundaysa model işini bitirdiğinde başlık ve özet görünür; bunun ne kadar süreceği donanımınıza bağlı. Sonuçtan memnunsanız Transkripsiyondan sonra otomatik özetle seçeneğini açın, böylece her yeni kayıt yazıya dökülür dökülmez özetini de alır.
Model seçimi
İki sayı önemli. Birincisi modelin dosya boyutu: toplantı uygulamanıza ve Autorec’e de yer kalacak şekilde RAM’e (ya da VRAM’e) sığması gerekir. İkincisi bağlam penceresi: modelin transkriptin ne kadarını aynı anda okuyabileceğini o belirler.
Ekim 2026 itibarıyla bunlar ollama.com/library üzerindeki etiketler. Boyutlar, orada varsayılan nicemleme için listelenen indirme boyutları.
| RAM’iniz | Model | İndirme boyutu |
|---|---|---|
| 8 GB | qwen3.5:4b | yaklaşık 3,3–4 GB |
| 16 GB | qwen3.5:9b veya gemma4:e4b | yaklaşık 6,6–7,6 GB |
| 32 GB | gemma4:26b veya qwen3.5:27b | yaklaşık 16–20 GB |
Bunlar bir model listesinden çıkarılmış başlangıç noktaları, kıyaslama sonuçları değil. Sizin için en iyi toplantı özetini hangisinin yazdığını görmek için kendi transkriptlerinizi ikisinden geçirin. Toplantılarınız Türkçeyse bu deneme ayrıca önemli: Whisper Türkçe konuşmayı yazıya döker, arayüz Türkçeyse özet de Türkçe istenir, ama küçük modellerin Türkçe metni ne kadar düzgün yazdığını ancak kendi transkriptinizle görürsünüz. Model kütüphaneleri hızlı değişiyor ve yukarıdaki adlar eskiyecek. İndirmeden önce kütüphane sayfasına bakın.
- 8 GB dar. Aynı makinede bir görüşme, ekran kaydı, bir Whisper geçişi ve bir model çalıştırıyor olabilirsiniz. 4B bir model iş görür, ama daha kaba özetler bekleyin ve model çalışırken diğer uygulamaları kapalı tutun.
- Transkripsiyon ve özetleme çakışmak zorunda değil. Autorec önce yazıya döker, sonra özetler; yani model ancak kayıt bittikten sonra belleğe ihtiyaç duyar.
- GPU çok fark yaratır. Yalnızca CPU ile 9B bir model kullanılabilir ama yavaştır. Bir saatlik bir transkript birkaç dakika sürebilir.
- Küçük modeller uzun girdide yoldan çıkar. Bir özet toplantının ikinci yarısını atlıyorsa, istemi suçlamadan önce daha büyük bir model deneyin.
Uzun toplantılar: bağlam uzunluğunu artırın
İnsanların en çok takıldığı ayar bu. Bir saatlik toplantı kabaca 9.000 kelimelik bir transkript eder; bu da 12.000 token civarı ya da daha fazlası demek. Bir model, bağlam penceresine ne sığıyorsa ancak o kadarını okuyabilir.
Ollama’nın belgelerine göre varsayılan bağlam uzunluğu VRAM’inize bağlı: 24 GiB’ın altında 4k token, 24–48 GiB arasında 32k, 48 GiB ve üzerinde 256k. Yani tipik bir dizüstünde ya da orta sınıf bir GPU’da varsayılan 4.096 token ve uzun bir transkript buna sığmaz: transkript, istem ve yanıtın hepsinin bu pencereye sığması gerekir. Net bir hata da almayabilirsiniz; yalnızca toplantının bir kısmını kapsayan bir özet gelir.
Artırmak için sunucu başlamadan önce OLLAMA_CONTEXT_LENGTH değişkenini ayarlayın:
OLLAMA_CONTEXT_LENGTH=32768 ollama serveOllama bir servis olarak çalışıyorsa değişkeni servis ortamına koyun. Linux’ta bu, systemctl edit ollama.service ile [Service] altına bir Environment="OLLAMA_CONTEXT_LENGTH=32768" satırı eklemek ve ardından yeniden başlatmak demek. Ollama masaüstü uygulamasının ayarlarında da bir bağlam uzunluğu kaydırıcısı var. Sonrasında bir özet oluşturulurken ollama ps çalıştırın ve yeni değerin geçerli olduğunu CONTEXT sütunundan doğrulayın.
Autorec’in Yapay zeka özeti ayarlarındaki Extra request fields (JSON) kutusu burada işe yaramaz. Ollama’nın OpenAI uyumlu uç noktasında bağlam boyutu için bir alan yok ve belgeleri de bunu söylüyor. Ortam değişkenine alternatif, PARAMETER num_ctx 32768 içeren bir Modelfile: bunu ollama create ile yeni bir model adı olarak derler ve o adı Model alanına yazarsınız.
Daha büyük bağlam daha fazla bellek ister. 32k token çoğu bir saatlik toplantı için yeterli ve ilk deneme için mantıklı bir değer. ollama ps modelin GPU ile CPU arasında bölündüğünü gösteriyorsa VRAM’inizin kaldırabileceğinden fazlasını istemişsiniz demektir; değeri düşürün ya da daha küçük bir model kullanın.
LM Studio’da bağlam uzunluğu her modelin yükleme ayarıdır. Modeli yüklerken ayarlayabilir, My Models’daki dişli simgesinden o modelin varsayılanı olarak kaydedebilirsiniz. En uzun toplantılarınızı karşılayan bir değer seçin ve bellek kullanımına göz kulak olun.
Autorec’in Yapay zeka özeti ayarlarındaki En fazla özet uzunluğu (token) değerine de bakın. Bu değer girdiyi değil, yanıtın uzunluğunu sınırlar. Yardım metnine göre 300 kısa bir paragraf, 1000 aşağı yukarı bir sayfa eder.
Sonuçta elinizde ne oluyor
Kayıt diskinizde bir .mp4 dosyası. Transkripti CPU’nuzda ya da GPU’nuzda Whisper üretiyor. Özet localhost üzerinde çalışan bir modelden geliyor. Hesap açmıyorsunuz ve hiçbir şirket hiçbir şeyin kopyasını tutmuyor. Bir müşteri görüşmesinin nereye gittiğini sorarsa tek cümleyle cevap verebilirsiniz. Aynı fikrin daha geniş bir anlatımı için Whisper ile toplantıları yerel olarak yazıya dökmek yazısına bakın.
Bedeli kalite ve hız. Bir dizüstünde çalışan 9B bir model, barındırılan bir API’deki en gelişmiş modellerle boy ölçüşemez. Bu fark sizin için önemliyse ara yollar var. AB’de barındırılan bir uç nokta üzerinden özetler veriyi GDPR kapsamında tutar, OpenRouter ise barındırılan modelleri kullandıkça öde fiyatlarıyla sunar.
Kurulum çalıştıktan sonra sıra isteme gelir. Genel bir özet yerine kararları, yapılacakları ve sorumluları almanın yolu özet istemini düzenlemek.
Sorun giderme
- Connection refused. Sunucu çalışmıyor. Ollama için
ollama psile kontrol edin ya da servisi yeniden başlatın. LM Studio için Start server anahtarının açık olduğundan emin olun. - Model bulunamadı. Model alanı, boyut eki de dahil olmak üzere etiketle ya da kimlikle birebir aynı olmalı.
- Toplantının sonunu görmezden gelen bir özet. Bağlam penceresi çok küçük. Yukarıda anlatıldığı gibi artırın.
Own your meeting recorder once
Local, private meeting recording for a one-time fee. No monthly bill, no assistant joining your calls.
See pricingİlgili yazılar
Yerel kayıt, transkripsiyon ve bunların etrafındaki otomasyon üzerine daha fazlası.

Whisper ile toplantıları yerel olarak yazıya dökmek
Toplantılarınızın transkriptini hiçbir yere yüklemeden almanın sessiz ve güvenilir bir yolu: yerel kayıt, yerel Whisper, isterseniz üstüne yapay zeka.

Toplantı transkriptinden yapılacaklar ve sorumlular
Autorec'in yerleşik özet istemi kararları ve yapılacakları zaten listeliyor. Tam olarak ne istediğini, sorumlu, son tarih ya da takip e-postası almak için yapıştırabileceğiniz iki istemi ve sorumluların neden yalnızca biri bir isim söylediğinde göründüğünü anlatıyoruz.
GDPR ve yapay zeka toplantı özetleri: Hangi uç nokta?
Autorec yalnızca transkripti, o da sizin seçtiğiniz yapay zeka sağlayıcısına gönderir. Bunun GDPR açısından ne anlama geldiğini, Mistral, Scaleway, IONOS, OpenAI ve Anthropic'in nasıl karşılaştırıldığını ve yerel bir modelin ne zaman daha iyi cevap olduğunu anlatıyoruz.