Підсумки зустрічей локальною LLM: Ollama і LM Studio
Запустіть і модель для підсумків на власному комп'ютері. Налаштуйте Ollama або LM Studio, вкажіть їх в Autorec, і ні запис, ні транскрипція, ні підсумок нікуди з комп'ютера не підуть.
Autorec і так записує й транскрибує на вашому комп’ютері. Підсумок — єдиний крок, який може вийти за його межі: для підсумку потрібна мовна модель, а більшість людей користується хмарною.
Але це не обов’язково. Autorec працює з будь-яким OpenAI-сумісним ендпоінтом, а Ollama і LM Studio обидва піднімають такий на localhost. Вкажіть його в Autorec, і на жодному етапі нічого не покине комп’ютер. Нижче покроково про обидва варіанти, потім про те, яку модель брати для 8, 16 чи 32 ГБ оперативної пам’яті і чому довгим зустрічам потрібне більше контекстне вікно, ніж стоїть за замовчуванням.
Що насправді надсилається
Autorec надсилає на ендпоінт дві речі: ваш промпт для підсумку як системне повідомлення і всю транскрипцію як повідомлення користувача. Ні аудіо, ні відео не надсилається. (Транскрипції, довші за приблизно 400 000 символів, а це близько восьми годин мовлення, Autorec обрізає й ставить позначку «[Transcript truncated]».) З локальним сервером цей запит іде на http://localhost:11434/v1 (Ollama) або http://localhost:1234/v1 (LM Studio) і далі нікуди не потрапляє.
Варіант 1: Ollama
- Встановіть Ollama з ollama.com/download. На Linux це скрипт
curl -fsSL https://ollama.com/install.sh | sh. На macOS і Windows звичайний інсталятор. - Завантажте модель у терміналі, наприклад
ollama pull qwen3.5:9b. Які моделі брати, розказано нижче. - Перевірте, що сервер працює: за замовчуванням Ollama слухає
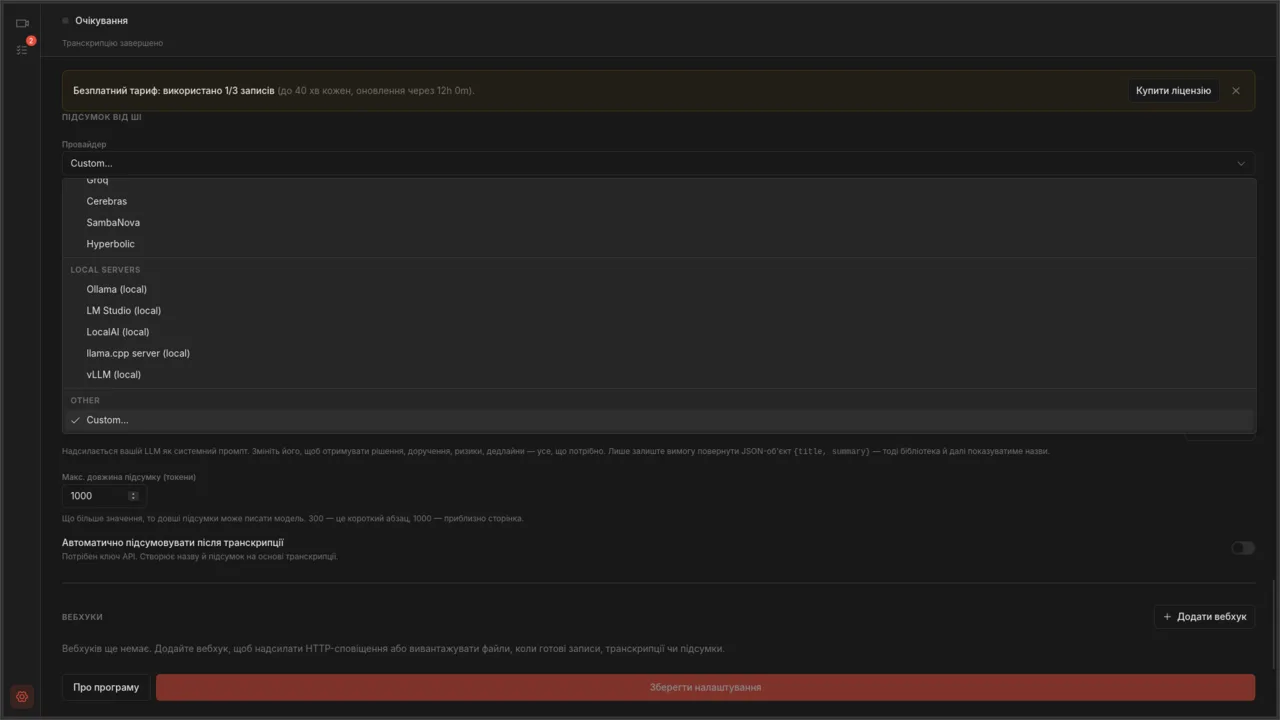
127.0.0.1:11434, аollama psпоказує, що зараз завантажено. - В Autorec відкрийте Налаштування й прокрутіть до розділу Підсумок від ШІ. У полі Провайдер виберіть Ollama (local) у групі Local servers. Базова URL-адреса API заповниться сама:
http://localhost:11434/v1. - Ключ API залиште порожнім. У полі написано «Not needed for local servers».
- У полі Модель вкажіть точний тег, який ви завантажили, наприклад
qwen3.5:9b. Пресет пропонуєllama3.1, але це спрацює, лише якщо ви завантажили саме її. - Натисніть Зберегти налаштування.
Варіант 2: LM Studio
- Встановіть LM Studio з lmstudio.ai і завантажте модель через вбудований пошук.
- Запустіть сервер. У вкладці Developer в LM Studio увімкніть Start server або виконайте в терміналі
lms server start. Сервер працює на порту 1234. - В Autorec у Налаштування → Підсумок від ШІ виберіть LM Studio (local) як Провайдер. Базова URL-адреса стане
http://localhost:1234/v1. - Ключ API залиште порожнім.
- У пресета LM Studio немає моделі за замовчуванням, тож введіть ідентифікатор моделі точно так, як його показує LM Studio.
- Натисніть Зберегти налаштування.
LM Studio простіший, якщо вам зручніше клацати мишкою, ніж вводити команди. Ollama легший і тихо працює у фоні без жодного вікна.
Перевірте на одному записі
Відкрийте в бібліотеці запис із транскрипцією й натисніть Створити підсумок. Якщо все працює, назва й підсумок з’являться, щойно модель закінчить, а скільки це триватиме, залежить від вашого заліза. Якщо результат влаштовує, увімкніть Автоматично підсумовувати після транскрипції, і кожен новий запис отримуватиме підсумок одразу після транскрипції.
Мова теж лишається вашою: Whisper розпізнає українську, а якщо інтерфейс Autorec українською, стандартний промпт просить модель написати назву й підсумок українською.
Яку модель вибрати
Важать два числа. Розмір файлу моделі: вона має вміститися в RAM (або VRAM), і ще має лишитися місце для програми для зустрічей та Autorec. І контекстне вікно: від нього залежить, скільки транскрипції модель прочитає за раз.
Станом на жовтень 2026 року це теги з ollama.com/library. Розміри взято звідти ж, для квантизації за замовчуванням.
| Ваша RAM | Модель | Розмір завантаження |
|---|---|---|
| 8 ГБ | qwen3.5:4b | приблизно 3,3–4 ГБ |
| 16 ГБ | qwen3.5:9b або gemma4:e4b | приблизно 6,6–7,6 ГБ |
| 32 ГБ | gemma4:26b або qwen3.5:27b | приблизно 16–20 ГБ |
Це відправні точки зі списку моделей, а не результати бенчмарків. Щоб дізнатися, яка модель пише найкращі підсумки саме для вас, проженіть свої транскрипції через дві з них. Бібліотеки моделей швидко змінюються, і назви вище застаріють. Перед завантаженням загляньте на сторінку бібліотеки.
- 8 ГБ — це впритул. На одному комп’ютері можуть одночасно працювати дзвінок, захоплення екрана, Whisper і модель. Модель на 4B впорається, але підсумки будуть грубішими, тож поки вона працює, закрийте інші програми.
- Транскрипція й підсумовування не обов’язково збігаються в часі. Autorec спершу транскрибує, а підсумовує потім, тож пам’ять моделі потрібна лише після завершення запису.
- GPU дуже допомагає. Лише на CPU модель 9B працює, але повільно. Транскрипція годинної зустрічі може оброблятися кілька хвилин.
- Менші моделі губляться на довгому тексті. Якщо підсумок пропускає другу половину зустрічі, спершу спробуйте більшу модель, а вже потім звинувачуйте промпт.
Довгі зустрічі: збільште довжину контексту
Саме на цьому налаштуванні люди найчастіше спотикаються. Годинна зустріч — це приблизно 9 000 слів транскрипції, тобто десь від 12 000 токенів і більше. Модель прочитає рівно стільки, скільки вміщує її контекстне вікно.
Документація Ollama каже, що довжина контексту за замовчуванням залежить від VRAM: 4k токенів, якщо її менше за 24 ГіБ, 32k при 24–48 ГіБ і 256k від 48 ГіБ. Тож на типовому ноутбуці чи GPU середнього класу за замовчуванням буде 4 096 токенів, і довга транскрипція не вміститься: у це вікно мають влізти і транскрипція, і промпт, і відповідь. Зрозумілої помилки ви, найімовірніше, не побачите, просто підсумок охопить лише частину зустрічі.
Щоб збільшити контекст, задайте OLLAMA_CONTEXT_LENGTH до запуску сервера:
OLLAMA_CONTEXT_LENGTH=32768 ollama serveЯкщо Ollama працює як служба, додайте змінну в оточення служби. На Linux це systemctl edit ollama.service з рядком Environment="OLLAMA_CONTEXT_LENGTH=32768" у секції [Service] і перезапуск. У десктопній програмі Ollama є повзунок довжини контексту в налаштуваннях. Потім, поки генерується підсумок, виконайте ollama ps і подивіться в стовпець CONTEXT, щоб переконатися, що нове значення застосувалося.
Поле Extra request fields (JSON) у налаштуваннях підсумку Autorec тут не допоможе. В OpenAI-сумісному ендпоінті Ollama немає поля для розміру контексту, і документація прямо про це каже. Альтернатива змінній оточення — Modelfile з PARAMETER num_ctx 32768: зберіть його через ollama create під новою назвою моделі й впишіть цю назву в поле Модель.
Більший контекст забирає більше пам’яті. 32k токенів вистачає для більшості годинних зустрічей, тож почати варто з цього. Якщо ollama ps показує, що модель розділена між GPU і CPU, ви попросили більше, ніж уміщує VRAM: зменште значення або візьміть меншу модель.
В LM Studio довжина контексту задається окремо для кожної моделі під час завантаження. Її можна вказати, коли завантажуєте модель, і зберегти як типову для цієї моделі через значок шестерні в My Models. Виберіть значення, якого вистачить на найдовші ваші зустрічі, і стежте за використанням пам’яті.
Перевірте також Макс. довжина підсумку (токени) у налаштуваннях підсумку Autorec. Це обмеження довжини відповіді, а не вхідного тексту. Підказка поруч пояснює: 300 — це короткий абзац, 1000 — приблизно сторінка.
Що ви отримуєте в результаті
Запис — це файл .mp4 на вашому диску. Транскрипцію створює Whisper на вашому CPU чи GPU. Підсумок пише модель, що працює на localhost. Жодних облікових записів, і жоден постачальник не тримає копії чогось вашого. Якщо клієнт спитає, куди подівся його дзвінок, відповідь уміститься в одне речення. Ширше про той самий підхід — у статті про локальну транскрипцію зустрічей за допомогою Whisper.
Платити доводиться якістю й швидкістю. Модель 9B на ноутбуці не дотягне до топової моделі через хмарний API. Якщо ця різниця важлива, є проміжні варіанти. Підсумки через ендпоінт із хостингом у ЄС тримають дані в рамках GDPR, а OpenRouter дає хмарні моделі з оплатою за використання.
Коли все запрацює, черга за промптом. Відредагувавши промпт для підсумку, ви отримуватимете рішення, доручення й відповідальних, а не загальний переказ.
Якщо щось не працює
- Connection refused. Сервер не запущено. Для Ollama перевірте
ollama psабо перезапустіть службу. Для LM Studio переконайтеся, що Start server увімкнено. - Model not found. Поле Модель має точно збігатися з тегом чи ідентифікатором, разом із суфіксом розміру.
- Підсумок ігнорує кінець зустрічі. Замале контекстне вікно. Збільште його, як описано вище.
Own your meeting recorder once
Local, private meeting recording for a one-time fee. No monthly bill, no assistant joining your calls.
See pricingСхожі статті
Більше про локальний запис, транскрипцію та автоматизацію довкола них.

Локальна транскрипція зустрічей за допомогою Whisper
Тихий і надійний спосіб отримувати транскрипції зустрічей, нікуди їх не вивантажуючи. Локальний запис, локальний Whisper і, за бажанням, ШІ поверх.

Доручення й відповідальні з транскрипції зустрічі
Вбудований промпт Autorec для підсумку вже виписує рішення й доручення. Що саме він просить, два готові промпти для відповідальних, термінів чи листа після зустрічі і чому відповідальні з'являються лише тоді, коли хтось назвав ім'я.
GDPR і ШІ-підсумки зустрічей: який ендпоінт вибрати
Autorec надсилає транскрипцію ШІ-провайдеру, якого вибираєте ви, і більше нічого. Що це означає з погляду GDPR, як порівнюються Mistral, Scaleway, IONOS, OpenAI та Anthropic і коли краще взяти локальну модель.