Autorec registra e trascrive già sul tuo computer. Il riepilogo è l’unico passaggio che può uscirne, perché serve un modello linguistico e la maggior parte delle persone ne usa uno in cloud.
Non è obbligatorio. Autorec parla con qualsiasi endpoint compatibile con OpenAI, e sia Ollama sia LM Studio ne espongono uno su localhost. Punta Autorec lì e niente lascia la macchina, in nessuna fase. Qui vediamo entrambi, poi quale modello scegliere con 8, 16 o 32 GB di RAM e perché le riunioni lunghe richiedono una finestra di contesto più ampia di quella predefinita.
Cosa viene inviato davvero
Autorec invia due cose all’endpoint: il tuo prompt di riepilogo come messaggio di sistema e l’intera trascrizione come messaggio utente. Niente audio, niente video. (Oltre i 400.000 caratteri circa, più o meno otto ore di parlato, Autorec taglia la trascrizione e aggiunge il marcatore ”[Transcript truncated]”.) Con un server locale la richiesta va a http://localhost:11434/v1 (Ollama) o http://localhost:1234/v1 (LM Studio) e si ferma lì.
Opzione 1: Ollama
- Installa Ollama da ollama.com/download. Su Linux lo script di installazione è
curl -fsSL https://ollama.com/install.sh | sh. Su macOS e Windows è un normale programma di installazione. - Scarica un modello da terminale, per esempio
ollama pull qwen3.5:9b. Trovi i modelli consigliati più sotto. - Controlla che sia attivo: per impostazione predefinita Ollama ascolta su
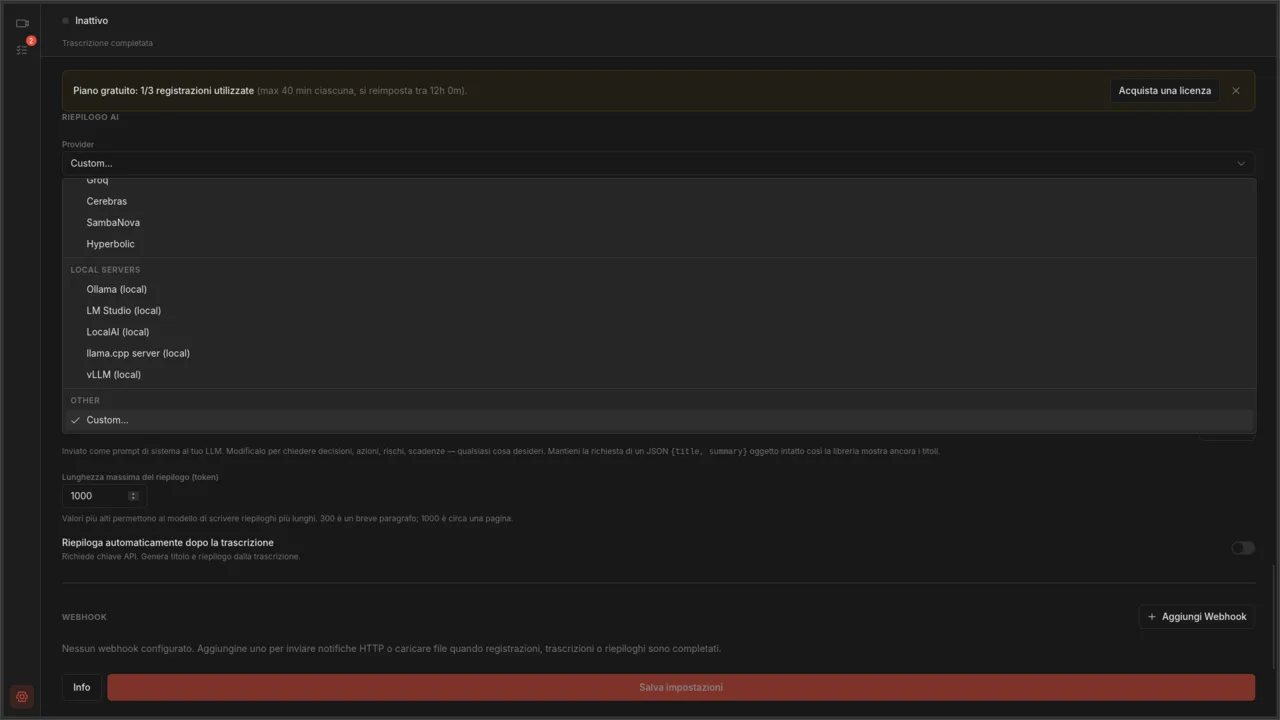
127.0.0.1:11434, eollama psmostra cosa è caricato. - In Autorec apri Impostazioni e scorri fino a Riepilogo AI. In Provider scegli Ollama (local) dal gruppo Local servers. L’URL base API si compila da solo con
http://localhost:11434/v1. - Lascia vuoto il campo Chiave API. Il campo indica “Not needed for local servers”.
- In Modello inserisci esattamente il tag che hai scaricato, per esempio
qwen3.5:9b. Il preset proponellama3.1, che funziona solo se hai scaricato proprio quello. - Fai clic su Salva impostazioni.
Opzione 2: LM Studio
- Installa LM Studio da lmstudio.ai e scarica un modello dalla ricerca integrata.
- Avvia il server. Nella scheda Developer di LM Studio attiva Start server, oppure esegui
lms server startda terminale. Il server risponde sulla porta 1234. - In Autorec, Impostazioni, Riepilogo AI, scegli LM Studio (local) come Provider. L’URL base diventa
http://localhost:1234/v1. - Lascia vuoto il campo Chiave API.
- Il preset di LM Studio non ha un modello predefinito, quindi scrivi l’identificativo del modello esattamente come lo mostra LM Studio.
- Fai clic su Salva impostazioni.
LM Studio è la scelta più comoda se preferisci cliccare invece di digitare comandi. Ollama è più leggero e resta in background senza finestra.
Provalo su una registrazione
Apri dalla libreria una registrazione che ha già la trascrizione e fai clic su Genera riepilogo. Se tutto funziona, titolo e riepilogo compaiono appena il modello ha finito, e quanto ci mette dipende dal tuo hardware. Quando il risultato ti convince, attiva Riepiloga automaticamente dopo la trascrizione: così ogni nuova registrazione riceve il suo riepilogo appena è trascritta.

Quale modello scegliere
Contano due numeri: la dimensione del file del modello, che deve stare in RAM (o VRAM) lasciando spazio all’app della riunione e ad Autorec, e la sua finestra di contesto, che decide quanta trascrizione riesce a leggere in una volta.
A ottobre 2026 questi sono tag presenti su ollama.com/library. Le dimensioni sono quelle di download indicate lì per la quantizzazione predefinita.
| La tua RAM | Modello | Dimensione del download |
|---|---|---|
| 8 GB | qwen3.5:4b | circa 3,3–4 GB |
| 16 GB | qwen3.5:9b o gemma4:e4b | circa 6,6–7,6 GB |
| 32 GB | gemma4:26b o qwen3.5:27b | circa 16–20 GB |
Sono punti di partenza presi da un elenco di modelli, non risultati di benchmark. Per capire quale scrive il riepilogo migliore per te, passa le tue trascrizioni a due di loro e confronta. Le librerie di modelli cambiano in fretta e questi nomi invecchieranno: controlla la pagina della libreria prima di scaricare.
- 8 GB sono pochi. Sulla stessa macchina potresti avere una chiamata, una cattura dello schermo, un passaggio di Whisper e un modello. Un modello 4B funziona, ma aspettati riepiloghi più grezzi e tieni chiuse le altre app mentre gira.
- Trascrizione e riepilogo non devono sovrapporsi. Autorec prima trascrive e poi riassume, quindi il modello ha bisogno di memoria solo a registrazione finita.
- Una GPU aiuta parecchio. Solo con la CPU un modello 9B è usabile ma lento: una trascrizione di un’ora può richiedere diversi minuti.
- I modelli piccoli perdono il filo sui testi lunghi. Se un riepilogo salta la seconda metà della riunione, prova un modello più grande prima di dare la colpa al prompt.
Riunioni lunghe: alza la lunghezza del contesto
È l’impostazione che frega più persone. Una riunione di un’ora produce circa 9.000 parole di trascrizione, cioè intorno ai 12.000 token o più. Un modello può leggere solo quanto entra nella sua finestra di contesto.
La documentazione di Ollama dice che la lunghezza di contesto predefinita dipende dalla VRAM: 4k token sotto i 24 GiB, 32k tra 24 e 48 GiB, 256k da 48 GiB in su. Quindi su un portatile tipico o una GPU di fascia media il default è 4.096 token, e una trascrizione lunga non ci sta: trascrizione, prompt e risposta devono entrare tutti in quella finestra. Potresti non ricevere un errore chiaro, solo un riepilogo che copre una parte della riunione.
Per alzarla, imposta OLLAMA_CONTEXT_LENGTH prima che il server parta:
OLLAMA_CONTEXT_LENGTH=32768 ollama serveSe Ollama gira come servizio, metti la variabile nell’ambiente del servizio. Su Linux si fa con systemctl edit ollama.service, aggiungendo una riga Environment="OLLAMA_CONTEXT_LENGTH=32768" sotto [Service], e poi riavviando. Anche l’app desktop di Ollama ha un cursore per la lunghezza del contesto nelle sue impostazioni. Dopo, esegui ollama ps mentre un riepilogo è in generazione e guarda la colonna CONTEXT per verificare che il nuovo valore sia attivo.
Il campo Extra request fields (JSON) nelle impostazioni Riepilogo AI di Autorec qui non serve. L’endpoint compatibile con OpenAI di Ollama non ha un campo per la dimensione del contesto, e la sua documentazione lo dice chiaramente. L’alternativa alla variabile d’ambiente è un Modelfile con PARAMETER num_ctx 32768, compilato con ollama create in un nuovo nome di modello da inserire nel campo Modello.
Un contesto più ampio costa memoria. 32k token bastano per la maggior parte delle riunioni da un’ora e sono un buon primo tentativo. Se ollama ps mostra il modello diviso tra GPU e CPU, hai chiesto più di quanto stia nella tua VRAM: abbassa il valore o usa un modello più piccolo.
In LM Studio la lunghezza del contesto è un’impostazione di caricamento di ciascun modello. Puoi impostarla quando carichi il modello e salvarla come predefinita per quel modello dall’icona a ingranaggio in My Models. Scegli un valore che copra le tue riunioni più lunghe e tieni d’occhio l’uso della memoria.
Controlla anche Lunghezza massima del riepilogo (token) nelle impostazioni Riepilogo AI di Autorec. Limita la lunghezza della risposta, non dell’input. Il testo di aiuto dice che 300 è un breve paragrafo e 1000 circa una pagina.
Cosa ottieni alla fine
La registrazione è un .mp4 sul tuo disco. La trascrizione la fa Whisper sulla tua CPU o GPU, e Whisper trascrive anche l’italiano. Il riepilogo arriva da un modello che gira su localhost e, con l’interfaccia di Autorec in italiano, il prompt predefinito lo fa scrivere in italiano. Non crei nessun account e nessun fornitore ha una copia di niente. Se un cliente ti chiede dove è finita la sua chiamata, rispondi in una frase. Per uno sguardo più ampio sulla stessa idea, leggi trascrivere le riunioni in locale con Whisper.
Il prezzo da pagare è qualità e velocità. Un modello 9B su un portatile non regge il confronto con un modello di punta su un’API in cloud. Se quel divario conta, ci sono vie di mezzo. I riepiloghi tramite un endpoint ospitato nell’UE mantengono i dati sotto il GDPR, e OpenRouter ti dà modelli in cloud a consumo.
Una volta che funziona, tocca al prompt. Modificare il prompt di riepilogo è il modo per ottenere decisioni, azioni da fare e responsabili invece di un riassunto generico.
Risoluzione dei problemi
- Connessione rifiutata. Il server non è in esecuzione. Per Ollama, controlla
ollama pso riavvia il servizio. Per LM Studio, verifica che Start server sia attivo. - Modello non trovato. Il campo Modello deve corrispondere esattamente al tag o all’identificativo, suffisso della dimensione compreso.
- Un riepilogo che ignora la fine della riunione. La finestra di contesto è troppo piccola. Alzala come descritto sopra.
Own your meeting recorder once
Local, private meeting recording for a one-time fee. No monthly bill, no assistant joining your calls.
See pricingArticoli correlati
Approfondimenti sulla registrazione locale, trascrizione e automazione correlata.

Trascrizione locale delle riunioni con Whisper
Un modo silenzioso e affidabile per ottenere trascrizioni delle tue riunioni senza caricarle da nessuna parte. Registrazione locale, Whisper locale, eventuale intelligenza artificiale aggiuntiva solo se la vuoi.

Azioni da fare e responsabili dalla trascrizione di una riunione
Il prompt di riepilogo integrato in Autorec elenca già decisioni e azioni da fare. Ecco cosa chiede esattamente, due prompt da incollare per ottenere responsabili, scadenze o un'email di follow-up, e perché i responsabili compaiono solo quando qualcuno pronuncia un nome.
GDPR e riepiloghi AI delle riunioni: quale endpoint usare
Autorec invia una trascrizione al provider AI che scegli tu, e nient'altro. Ecco cosa significa ai sensi del GDPR, come si confrontano Mistral, Scaleway, IONOS, OpenAI e Anthropic, e quando un modello locale è la risposta migliore.