Podsumowania spotkań przez OpenRouter: jeden klucz, dowolny model
Skonfiguruj Podsumowanie AI w Autorec z OpenRouter w pięciu krokach i zobacz, ile kosztuje jedno podsumowanie: ułamek centa na tanim modelu, kilka centów na czołowym.
Autorec nagrywa i transkrybuje twoje rozmowy na twoim własnym komputerze. Podsumowanie to jedyny opcjonalny krok, który korzysta z modelu językowego, a ty wybierasz, z którego. Jeśli nie chcesz zakładać konta najpierw w OpenAI, potem w Anthropic, a potem w Google tylko po to, żeby je porównać, OpenRouter daje ci jeden klucz API i jeden rachunek za wszystkie.
Czym jest OpenRouter, w jednym akapicie
OpenRouter to bramka API. Wysyłasz żądanie w stylu OpenAI pod https://openrouter.ai/api/v1, podajesz model, na przykład openai/gpt-4o-mini albo anthropic/claude-sonnet-5.5, a OpenRouter kieruje wywołanie do dostawcy, który ten model obsługuje. Autorec mówi tym samym formatem chat completions, więc OpenRouter działa jako endpoint bez żadnych przeróbek. Według FAQ OpenRouter sama inferencja nie ma marży, a opłata jest doliczana przy zakupie kredytów (5,5% kartą, 5% kryptowalutą w chwili pisania).
Haczyk: tekst transkrypcji opuszcza twój komputer i przechodzi przez OpenRouter do dostawcy, który uruchamia model. Dźwięk i wideo nigdy. Jeśli przy twoich rozmowach ma to znaczenie, przeczytaj o prywatności w OpenRouter, zanim wybierzesz model, albo użyj modelu lokalnego.
Konfiguracja w Autorec
- Załóż konto w OpenRouter i doładuj kredyty. Zrobisz to na stronie kredytów w ustawieniach konta. Przy cenach podanych niżej kilka dolarów wystarcza na długo.
- Utwórz klucz API. Wejdź do sekcji kluczy w ustawieniach konta OpenRouter i skopiuj klucz w bezpieczne miejsce. Zobaczysz go tylko raz.
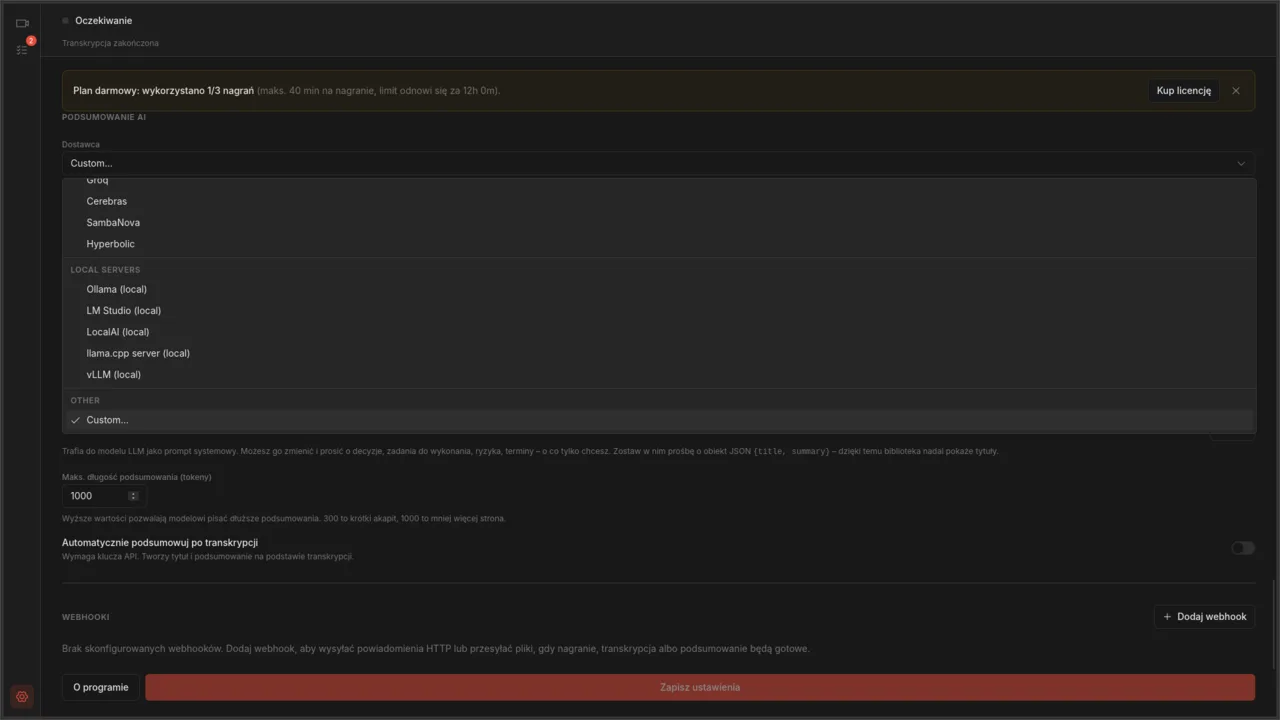
- Otwórz Ustawienia w Autorec i przewiń do sekcji Podsumowanie AI. W polu Dostawca wybierz OpenRouter z grupy Aggregators. Preset uzupełni bazowy URL API (
https://openrouter.ai/api/v1) i domyślny model. - Wklej klucz w pole Klucz API, a w polu Model ustaw wybrany model. Nazwy modeli mają w OpenRouter postać
dostawca/model, na przykładanthropic/claude-haiku-4.5. - Kliknij Zapisz ustawienia. Potem otwórz dowolne nagranie z transkrypcją i kliknij Utwórz podsumowanie albo włącz Automatycznie podsumowuj po transkrypcji, żeby działo się to samo.
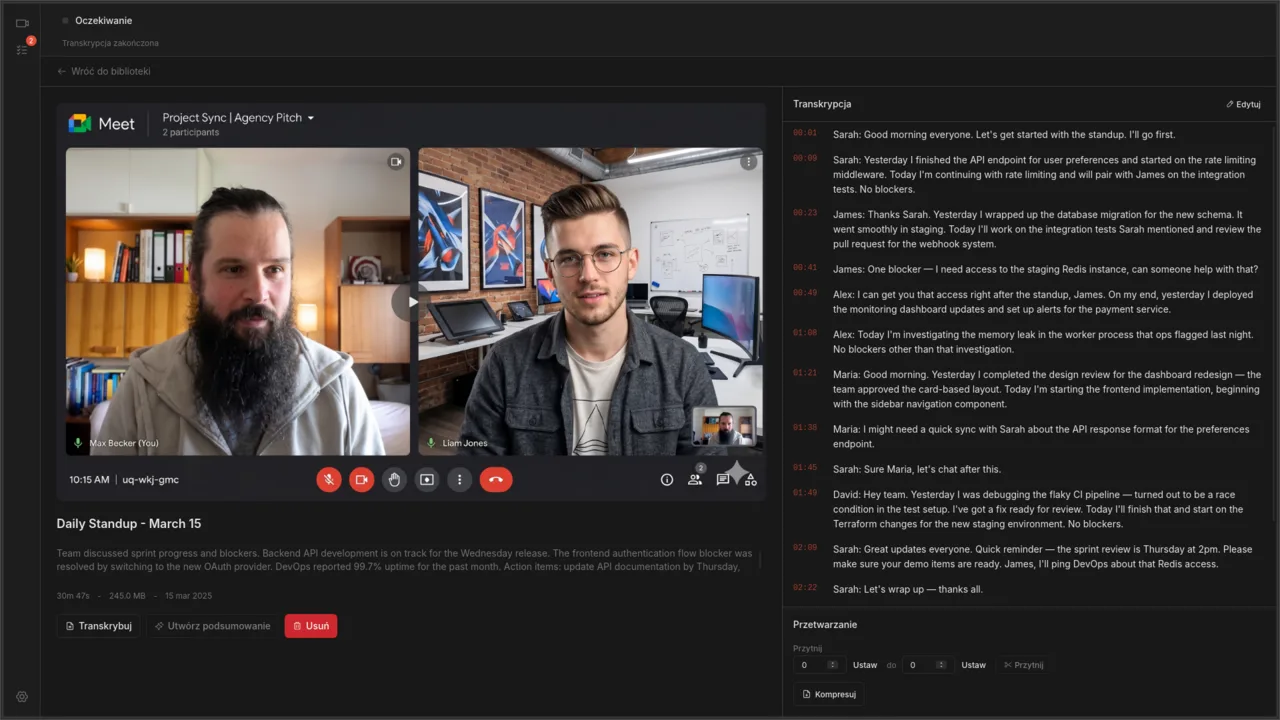
Podsumowanie pojawia się obok wideo w twojej bibliotece. Domyślny prompt prosi o tytuł, jednozdaniowe streszczenie, sekcję z decyzjami i sekcję z zadaniami wraz z osobami odpowiedzialnymi tam, gdzie ktoś je wskazał. Możesz go przepisać. Jak to zrobić, pokazuje wpis o prompcie do zadań ze spotkania.
Co Autorec faktycznie wysyła
Autorec wysyła prompt systemowy i transkrypcję jako dwie wiadomości czatu i prosi o odpowiedź nie dłuższą niż wartość ustawiona w Maks. długość podsumowania (tokeny) (domyślnie 1000; pole przyjmuje od 100 do 2000).
Autorec wysyła całą transkrypcję. Przycinana jest tylko bardzo długa rozmowa (powyżej mniej więcej 400 000 znaków, czyli około ośmiu godzin mowy), ze znacznikiem „[Transcript truncated]” na końcu.
Które modele dobrze radzą sobie z transkrypcjami spotkań
Godzinna transkrypcja to około 11 500 tokenów, więc każdy z poniższych modeli ma spory zapas (wszystkie mają okno kontekstu co najmniej 128k). Różnią się tym, jak trzymają się formatu i jak radzą sobie z chaotyczną mową.
- Tanie i wystarczające:
openai/gpt-4o-mini(domyślny w presecie) ideepseek/deepseek-v4.1-flash. Oba dają czytelne streszczenie i listy punktowane dla daily albo rozmowy z klientem. Licz się z tym, że czasem przypiszą zadanie niewłaściwej osobie. - Średnia półka:
anthropic/claude-sonnet-5.5. Lepiej odróżnia prawdziwą decyzję od luźnej propozycji i lepiej pilnuje, kto za co odpowiada, gdy kilka osób mówi naraz. - Czołówka:
anthropic/claude-opus-5.5. Warto spróbować przy rozmowie o wysokiej stawce, na podstawie której będziesz działać. Przy rutynowych spotkaniach zysk względem średniej półki jest niewielki.
To moja ocena na podstawie tego, jak te klasy modeli zwykle zachowują się przy tym zadaniu, a nie benchmark. Przepuść jedną prawdziwą transkrypcję przez dwa modele i porównaj. Na tanich modelach kosztuje to ułamek centa.
Praktyczna wskazówka: modele rozumujące mogą zużyć część limitu odpowiedzi na tokeny myślenia. Jeśli podsumowanie wraca puste albo ucięte, zwiększ Maks. długość podsumowania (tokeny) albo wybierz model bez rozumowania.
Ile kosztuje podsumowanie
Założenia: godzinne spotkanie przy 130–150 wypowiadanych słowach na minutę to mniej więcej 8000–9000 słów, czyli około 11 500 tokenów. Do tego około 110 tokenów domyślnego promptu, co daje 11 600 tokenów na wejściu. Zakładam 500 tokenów podsumowania na wyjściu. Ceny pochodzą z aktualnej listy modeli OpenRouter, za milion tokenów, stan na październik 2026.
| Model | Wejście / wyjście za 1M tokenów | Koszt podsumowania (11 600 na wejściu, 500 na wyjściu) |
|---|---|---|
deepseek/deepseek-v4.1-flash | $0.0472 / $0.12 | ok. $0.0006 |
openai/gpt-4o-mini | $0.15 / $0.60 | ok. $0.002 |
anthropic/claude-sonnet-5.5 | $2 / $10 | ok. $0.028 |
anthropic/claude-opus-5.5 | $4 / $20 | ok. $0.056 |
Jeden wiersz rozpisany: Sonnet to 11 600 × $2 / 1 000 000 = $0.0232 za wejście plus 500 × $10 / 1 000 000 = $0.0050 za wyjście, razem $0.0282.
Sto godzinnych spotkań kosztuje około sześciu centów na DeepSeek, dwadzieścia centów na GPT-4o mini, $2.82 na Sonnecie i $5.64 na Opusie. Dominuje wejście, więc dłuższa rozmowa kosztuje proporcjonalnie więcej, a koszt wyjścia zostaje ten sam.
Darmowe modele
OpenRouter ma modele z sufiksem :free, na przykład google/gemma-4-31b-it:free. Według FAQ OpenRouter darmowe użycie jest ograniczone do 50 żądań dziennie bez kredytów albo 1000 dziennie, jeśli kupiłeś kredyty za co najmniej $10. To aż nadto na kilka spotkań dziennie.
Jeśli chodzi o prywatność, nie znalazłem w dokumentacji OpenRouter informacji, jak darmowe endpointy obchodzą się z promptami. Dokumentacja mówi natomiast, że konta mają osobne ustawienia prywatności dla płatnych i darmowych modeli i że możesz decydować, czy żądania mogą trafiać do dostawców, którzy mogą trenować na twoich danych. Dopóki sam tych ustawień nie sprawdzisz, zakładaj, że darmowy endpoint może przechowywać to, co wysyłasz, albo na tym trenować, i nie przepuszczaj przez niego rozmów z klientami. Wpis o prywatności w OpenRouter omawia te ustawienia.
W sekcji Podsumowanie AI Autorec ma też pole Extra request fields (JSON). Przy wybranym presecie OpenRouter przycisk Use privacy settings wpisuje w nie {"provider": {"zdr": true, "data_collection": "deny"}}, czyli prosi OpenRouter, żeby kierował żądania tylko do dostawców z zerową retencją danych, którzy nie zbierają twoich danych. Wpis o prywatności wyjaśnia, co to daje i co ogranicza.
Rozsądny punkt startowy
Zacznij od domyślnego modelu z presetu, openai/gpt-4o-mini, na jednym ze swoich daily. Jeśli osoby odpowiedzialne albo decyzje wychodzą źle, przejdź na anthropic/claude-sonnet-5.5. Opusa zostaw na rozmowy, w których przeoczone zadanie ma swoją cenę. Zmiana to jedno pole w Ustawieniach, a klucz zostaje ten sam.
Autorec kupujesz raz, więc podsumowania to jedyny bieżący koszt. Co jeszcze potrafi aplikacja, zobaczysz na stronie funkcji, a ustawienia opisuje dokumentacja konfiguracji.
Own your meeting recorder once
Local, private meeting recording for a one-time fee. No monthly bill, no assistant joining your calls.
See pricingPowiązane artykuły
Więcej o lokalnym nagrywaniu, transkrypcji i automatyzacji wokół nich.
Jak zachować prywatność transkrypcji spotkań w OpenRouter
OpenRouter może skierować twoją transkrypcję do dziesiątek dostawców, a część z nich przechowuje prompty. Trzy ustawienia konta i opcjonalny bazowy URL w UE decydują o tym, którzy ją zobaczą.
Podsumowania spotkań z lokalnym LLM: Ollama i LM Studio
Model do podsumowań też może działać na twoim komputerze. Skonfiguruj Ollamę albo LM Studio, wskaż je w Autorec, a nagranie, transkrypcja i podsumowanie nigdy nie opuszczą twojego sprzętu.

Zadania i osoby odpowiedzialne prosto z transkrypcji spotkania
Wbudowany prompt podsumowania w Autorec już teraz wypisuje decyzje i zadania. Pokazujemy, o co dokładnie prosi, dajemy dwa prompty do wklejenia, które dodają osoby odpowiedzialne, terminy albo gotowego maila po spotkaniu, i wyjaśniamy, dlaczego osoba odpowiedzialna pojawia się tylko wtedy, gdy ktoś wypowie jej imię.