Autorec 本来就在你的电脑上录制和转录。唯一可能离开电脑的一步是摘要:写摘要需要语言模型,而大多数人用的是云端托管的模型。
其实不必如此。Autorec 能对接任何兼容 OpenAI 的端点,而 Ollama 和 LM Studio 都会在 localhost 上提供这样一个端点。把 Autorec 指向那里,整个流程中就没有任何东西离开这台机器。本文把两种方案都走一遍,再讲 8、16、32 GB 内存各该选什么模型,以及为什么长会议需要比默认值更大的上下文窗口。
到底发送了什么
Autorec 向端点发送两样东西:你的摘要提示词作为 system 消息,完整的转录文本作为 user 消息。不发送任何音频或视频。(转录文本超过约 400,000 个字符,大约八小时的讲话,Autorec 会截断并加上“[Transcript truncated]”标记。)用本地服务器时,这个请求发往 http://localhost:11434/v1(Ollama)或 http://localhost:1234/v1(LM Studio),到此为止。
方案一:Ollama
- 从 ollama.com/download 安装 Ollama。Linux 上的安装脚本是
curl -fsSL https://ollama.com/install.sh | sh,macOS 和 Windows 上是普通的安装程序。 - 在终端里拉取一个模型,比如
ollama pull qwen3.5:9b。怎么选模型见下文。 - 确认它在运行:Ollama 默认监听
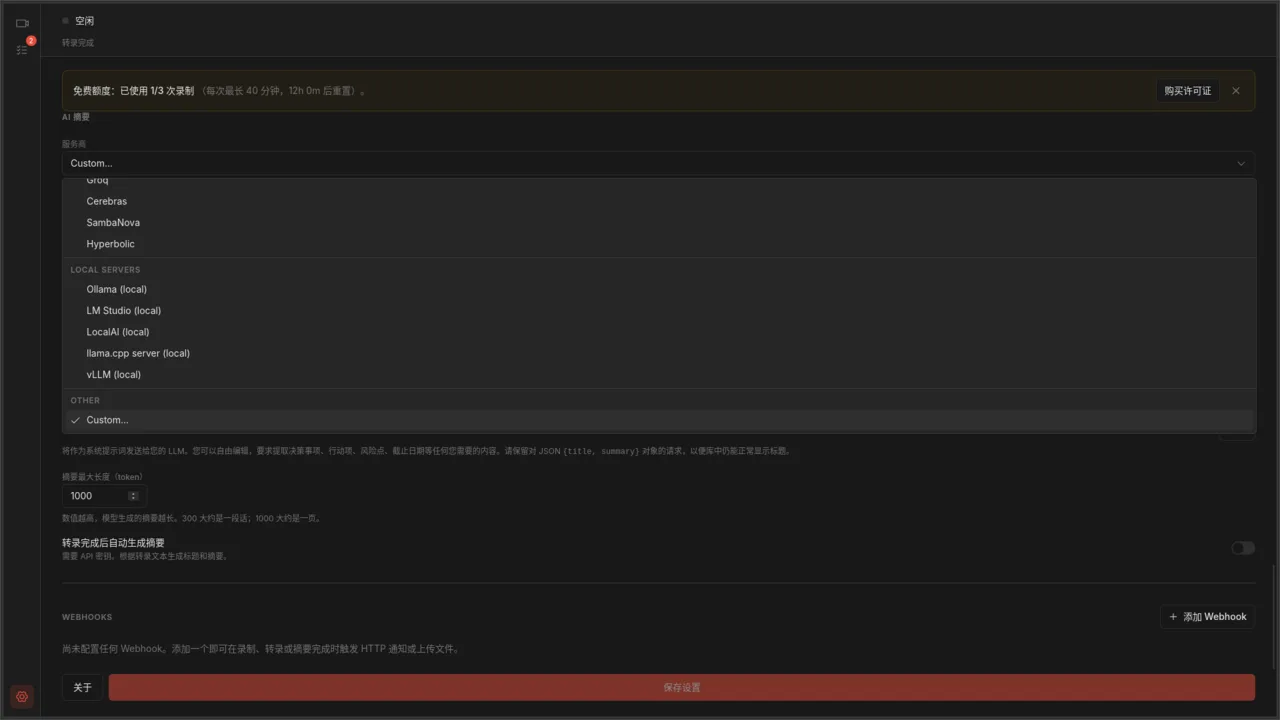
127.0.0.1:11434,ollama ps会显示已加载的模型。 - 在 Autorec 里打开 设置,滚动到 AI 摘要。在 服务商 下,从 Local servers 分组中选择 Ollama (local)。API 基础 URL 会自动填成
http://localhost:11434/v1。 - API 密钥 留空。输入框里写着“Not needed for local servers”。
- 把 模型 设为你拉取的确切标签,例如
qwen3.5:9b。预设建议的是llama3.1,只有你拉取过这个模型时它才能用。 - 点击 保存设置。
方案二:LM Studio
- 从 lmstudio.ai 安装 LM Studio,用它内置的搜索下载一个模型。
- 启动服务器。在 LM Studio 的 Developer 标签页里打开 Start server,或者在终端运行
lms server start。它在 1234 端口提供服务。 - 在 Autorec 的 设置、AI 摘要 中,把 服务商 选为 LM Studio (local)。基础 URL 会变成
http://localhost:1234/v1。 - API 密钥 留空。
- LM Studio 预设没有默认模型,所以要按 LM Studio 显示的样子原样输入模型标识符。
- 点击 保存设置。
如果你更愿意点鼠标而不是敲命令,LM Studio 更顺手。Ollama 更轻量,没有窗口,安静地待在后台。
先拿一段录像试试
在媒体库里打开一段已经有转录文本的录像,点击 生成摘要。如果一切正常,模型跑完后标题和摘要就会出现,快慢取决于你的硬件。满意之后,打开 转录完成后自动生成摘要,每段新录像转录一结束就会自动得到摘要。

怎么选模型
有两个数字要看:一是模型文件大小,它得装进内存(或显存),还要给会议软件和 Autorec 留出空间;二是上下文窗口,它决定模型一次能读多少转录文本。
截至 2026 年 10 月,下面这些都是 ollama.com/library 上的标签。大小是那里列出的默认量化版本的下载大小。
| 你的内存 | 模型 | 下载大小 |
|---|---|---|
| 8 GB | qwen3.5:4b | 约 3.3 至 4 GB |
| 16 GB | qwen3.5:9b 或 gemma4:e4b | 约 6.6 至 7.6 GB |
| 32 GB | gemma4:26b 或 qwen3.5:27b | 约 16 至 20 GB |
这些是从模型列表里挑出的起点,不是跑分结果。想知道哪个最适合给你写会议摘要,就拿你自己的转录文本在其中两个模型上各跑一遍。模型库更新很快,上面的名字会过时,拉取之前先看一眼模型库页面。
- 8 GB 很紧张。同一台机器上可能同时跑着通话、屏幕录制、一次 Whisper 转录和一个模型。4B 模型能用,但摘要会粗糙一些,运行时最好把其他应用关掉。
- 转录和摘要不必同时进行。Autorec 先转录、后摘要,所以模型只在录制结束后才需要占用内存。
- 有 GPU 会快很多。只用 CPU 时,9B 模型能用但很慢,一小时的转录文本可能要几分钟。
- 小模型处理长输入容易跑偏。如果摘要漏掉了会议的后半段,先换个大点的模型,再去怀疑提示词。
长会议:调大上下文长度
这是最容易踩坑的设置。一小时的会议大约有 9,000 个英文单词的转录文本,折合约 12,000 个 token 甚至更多。模型能读的内容不会超过它的上下文窗口。
Ollama 的文档说,默认上下文长度取决于你的显存:24 GiB 以下为 4k token,24 至 48 GiB 为 32k,48 GiB 及以上为 256k。所以在普通笔记本或中端显卡上,默认值是 4,096 个 token,长转录文本根本放不下:转录文本、提示词和回复都得挤在这个窗口里。你可能不会看到明确的报错,只会得到一份只覆盖了部分会议的摘要。
要调大它,在服务器启动前设置 OLLAMA_CONTEXT_LENGTH:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve如果 Ollama 是作为系统服务运行的,就把这个变量写进服务的环境配置。在 Linux 上是运行 systemctl edit ollama.service,在 [Service] 下加一行 Environment="OLLAMA_CONTEXT_LENGTH=32768",然后重启服务。Ollama 桌面应用的设置里也有一个上下文长度滑块。改完后,在生成摘要的同时运行 ollama ps,看 CONTEXT 一列,确认新值已经生效。
Autorec AI 摘要设置里的 Extra request fields (JSON) 框在这里帮不上忙。Ollama 兼容 OpenAI 的端点没有设置上下文大小的字段,它的文档里也写明了。除了环境变量,另一个办法是写一个包含 PARAMETER num_ctx 32768 的 Modelfile,用 ollama create 构建成一个新模型名,再把这个名字填进 模型 字段。
上下文越大越吃内存。32k token 足够应付大多数一小时的会议,可以先试这个值。如果 ollama ps 显示模型被拆分到 GPU 和 CPU 上,说明你要的超出了显存容量,那就调小一点,或者换个更小的模型。
在 LM Studio 里,上下文长度是每个模型的加载设置。你可以在加载模型时设置,也可以在 My Models 里点齿轮图标,把它保存为该模型的默认值。选一个能覆盖你最长会议的数值,同时留意内存占用。
另外也看一下 Autorec AI 摘要设置里的 摘要最大长度(token)。它限制的是回复的长度,而不是输入。说明文字里写着:300 大约是一段话,1000 大约是一页。
最终得到什么
录像是你磁盘上的一个 .mp4 文件。转录文本由 Whisper 在你的 CPU 或 GPU 上生成。摘要来自运行在 localhost 上的模型。中文会议同样适用:Whisper 能转录中文,Autorec 界面设为中文时,默认提示词会要求模型用简体中文写标题和摘要。不用注册任何账号,也没有任何厂商持有副本。如果客户问起他们的通话去了哪里,一句话就能说清楚。同一思路的更完整介绍,见用 Whisper 在本地转录会议。
代价是质量和速度。笔记本上的 9B 模型比不上托管 API 上的前沿模型。如果这个差距对你很重要,也有折中方案:通过欧盟托管的端点生成摘要可以让数据处于 GDPR 的保护之下,OpenRouter 则让你按用量付费使用托管模型。
跑通之后,下一步就是提示词。修改摘要提示词能让你得到决策、待办事项和负责人,而不是一段泛泛的回顾。
故障排查
- Connection refused(连接被拒绝)。 服务器没在运行。Ollama 的话,检查
ollama ps或重启服务;LM Studio 的话,确认 Start server 已打开。 - Model not found(找不到模型)。 模型 字段必须和标签或标识符完全一致,包括表示大小的后缀。
- 摘要忽略了会议结尾。 上下文窗口太小。按上文的方法调大。
Own your meeting recorder once
Local, private meeting recording for a one-time fee. No monthly bill, no assistant joining your calls.
See pricing相关文章
更多关于本地录制、转录及其自动化的内容。


从会议转录文本中提取待办事项和负责人
Autorec 内置的摘要提示词已经会列出决策和待办事项。本文给出它的原文、两段可以直接粘贴的提示词(用来提取负责人、截止日期或生成跟进邮件),并解释为什么只有有人说出名字时,负责人才会出现。
GDPR 与 AI 会议摘要:该用哪个端点
Autorec 只把转录文本发给你选定的 AI 服务商,别的什么都不发。本文讲清这在 GDPR 下意味着什么,比较 Mistral、Scaleway、IONOS、OpenAI 和 Anthropic,并说明什么时候本地模型才是更好的答案。